CoreWeave conecta cientos de GPUs Rubin en clúster multi-rack
⏱ Tiempo de lectura: 4 min
CoreWeave anunció el 16 de septiembre de 2026 la activación de múltiples racks con GPU NVIDIA Vera Rubin NVL72 en su plataforma en la nube, integrando cientos de GPU Rubin en un único clúster escalable diseñado para IA agéntica. La empresa también presentó nuevas capacidades en CoreWeave AI Object Storage: aceleración de escritura entre regiones y un nuevo nivel Archive. Chen Goldberg, vicepresidente ejecutivo de producto e ingeniería en CoreWeave, destacó que la empresa es la primera proveedora de nube de IA en validar y activar Vera Rubin NVL72.
Arquitectura multi-rack y capacidades integradas
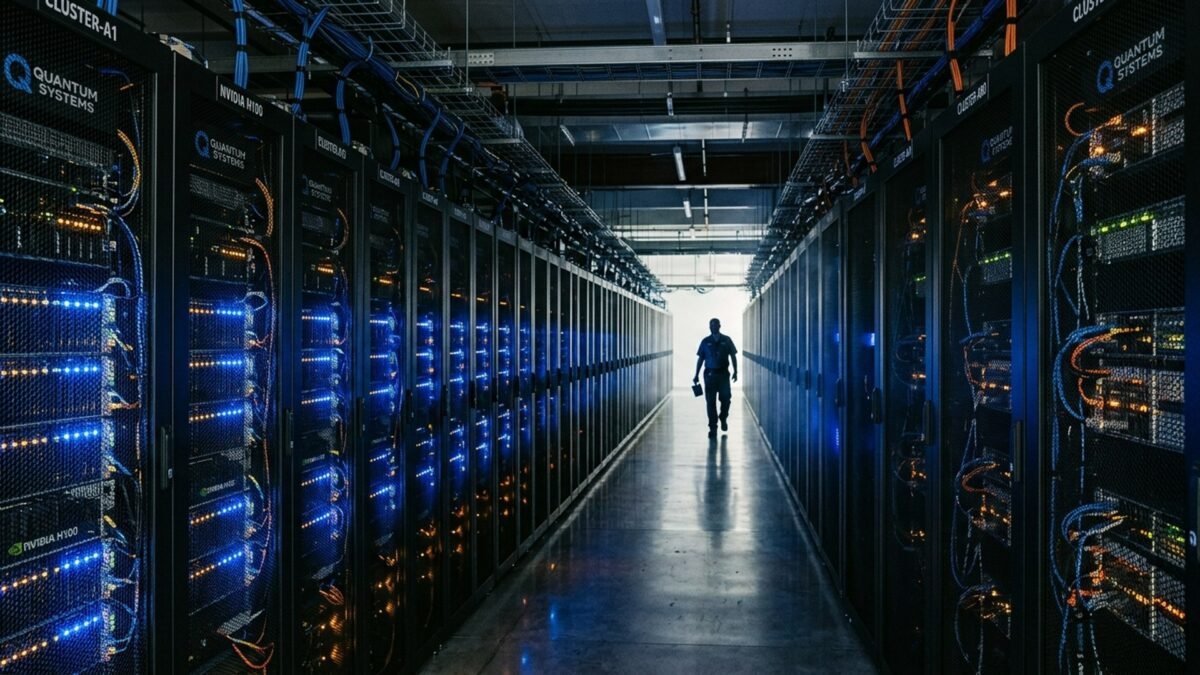
Un único rack Vera Rubin NVL72 combina 72 GPU Rubin con 36 CPU Vera, NVLink 6, SuperNICs ConnectX-9 y DPU BlueField-4. Con configuración multi-rack, CoreWeave unifica cientos de aceleradores usando red Ethernet NVIDIA Spectrum-X en un clúster único escalable. El sistema entrega capacidad para entrenar modelos más grandes, servir cargas de trabajo de inferencia exigentes y ejecutar aprendizaje por refuerzo a escala. CoreWeave utiliza automatización mediante Mission Control, que incluye el Rack LifeCycle Controller para configuración de hardware, actualizaciones de firmware y validación. Cada GPU Rubin porta dos SuperNICs ConnectX-9 que proporcionan 1,6 Tb/s de conectividad escalable. La arquitectura soporta aproximadamente 128.000 GPU por rail en fabric sin bloqueos. En Hardware, esta capacidad representa un avance significativo para infraestructura de IA a gran escala.
Especificaciones y mejoras de almacenamiento
Vera Rubin NVL72 ofrece 20,7 TB de memoria HBM4 con ancho de banda de 1.400 TB/s, ancho de banda NVLink de 216 TB/s sobre NVLink de sexta generación, y 3.600 PFLOPS de computación sparse NVFP4 por rack. Los 36 CPU Vera proveen 3.168 núcleos Olympus personalizados y hasta 54 TB de memoria LPDDR5X. NVIDIA indica que Vera Rubin NVL72 entrena modelos mixture-of-experts con un cuarto de GPU comparado con GB200 NVL72, y ofrece inferencia a un décimo del costo por millón de tokens. CoreWeave AI Object Storage introduce Local Object Transport Accelerator (LOTA) con caché gestionado que entrega lecturas a velocidad NVMe local, reduce latencia 8x versus almacenamiento tradicional, y proporciona hasta 7 GB/s de throughput por GPU. La aceleración de escritura entre regiones permite escribir checkpoints localmente con latencia local mientras los datos migran en segundo plano. Archive es un nivel de almacenamiento de menor costo sin tarifas por recuperación, eliminación temprana ni lectura. Fuente: www.unite.ai
Impacto para cargas de trabajo agénticas
Para equipos que construyen IA agéntica, la arquitectura multi-rack permite mayor escala, iteración más rápida y productividad superior conforme los modelos y agentes aprenden continuamente. Las cargas de trabajo multi-paso agéntnicas son sensibles a latencia de acceso a datos, porque los retrasos se amplifican en llamadas repetidas de modelo y uso de herramientas. Cécile Robert-Michon, directora de infraestructura interna en Cohere, destacó que con datasets distribuidos en múltiples regiones, CoreWeave AI Object Storage proporciona huella de dataset unificada con lecturas cacheadas localmente, evitando esperas en red. CoreWeave reporta récords en benchmarks MLPerf para inferencia y entrenamiento, clasificación Platinum en SemiAnalysis ClusterMAX 1.0 y 2.0, y rankings #1 en velocidad de inferencia y precio-rendimiento para modelos Kimi K2.6 y K2.7 Code de Moonshot AI según Artificial Analysis.
Qué se puede esperar ahora
La disponibilidad de múltiples racks Vera Rubin NVL72 como servicio en nube simplifica el acceso a infraestructura de IA de alto rendimiento sin inversión directa en hardware. Equipos de investigación y productivos pueden iterar más rápido en modelos agénticos y cargas de trabajo complejas. La madurez del stack de CoreWeave, desde orchestración de racks hasta almacenamiento distribuido, plantea un cambio en cómo se ejecuta infraestructura de IA a escala dentro de proveedores en nube especializados.
| Componente | Especificación |
|---|---|
| GPU por rack | 72 GPU NVIDIA Rubin |
| CPU por rack | 36 CPU NVIDIA Vera |
| Memoria HBM4 | 20,7 TB con ancho de banda 1.400 TB/s |
| Ancho de banda NVLink | 216 TB/s (sexta generación) |
| Computación sparse NVFP4 | 3.600 PFLOPS por rack |
| Conectividad por GPU | 1,6 Tb/s via ConnectX-9 SuperNICs |
| Escala máxima fabric | ~128.000 GPU por rail sin bloqueos |
| LOTA throughput | Hasta 7 GB/s por GPU |
| Reducción de latencia LOTA | 8x versus almacenamiento tradicional |
| Lanzamiento anunciado | 16 de septiembre de 2026 |
| Proveedor | CoreWeave en CoreWeave Cloud |
Preguntas frecuentes sobre CoreWeave y Vera Rubin
¿Qué es la arquitectura multi-rack Vera Rubin NVL72?
Es la integración de múltiples racks físicos con 72 GPU Rubin y 36 CPU Vera cada uno, unidos mediante red Ethernet NVIDIA Spectrum-X en un único clúster lógico escalable, permitiendo entrenar modelos grandes y ejecutar inferencia agéntica con latencia optimizada.
¿Cuándo estará disponible para usar?
CoreWeave anunció la activación el 16 de septiembre de 2026, indicando que ya valida y ejecuta este sistema como servicio en nube. No se especifica en el texto fuente recibido una fecha de disponibilidad general para nuevos usuarios ni ventanas de onboarding.
¿Cuál es el precio o modelo de acceso?
No se especifica en el texto fuente recibido el precio, costo por compute-hour ni opciones de suscripción. CoreWeave ofrece acceso a través de CoreWeave Cloud como proveedor especializado de infraestructura de IA.
¿Por qué importa para IA agéntica?
Las cargas de trabajo agéntnicas multi-paso requieren múltiples llamadas a modelo con acceso a datos constante. La latencia se amplifica en cada paso, por lo que tener cientos de GPU en un clúster cohesivo con almacenamiento local cacheado reduce retrasos y acelera iteración de agentes y modelos.
Qué falta por confirmar
La fuente no detalla el precio o modelo de facturación, disponibilidad regional específica, benchmarks de rendimiento real en cargas de IA agéntica comparadas con otras plataformas, ni cronograma de acceso para nuevos clientes. Tampoco especifica SLAs, capacidad máxima de reserva simultánea ni roadmap de expansión de racks.
En Inteligencia Artificial, este anuncio refleja la madurez de proveedores especializados que integran hardware de NVIDIA con orquestación y almacenamiento optimizado. La pregunta central es si esta oferta de infraestructura multi-rack reducirá significativamente el time-to-market para equipos que desarrollan sistemas agénticos complejos.
Deja una respuesta
Lo siento, debes estar conectado para publicar un comentario.