Almacenamiento de IA: el costo oculto de la inferencia
⏱ Tiempo de lectura: 4 min
El costo real de la infraestructura de inteligencia artificial va mucho más allá de las GPU. Un análisis de Western Digital revela que el almacenamiento de datos generados durante la inferencia representa un gasto significativo y frecuentemente subestimado en los presupuestos de empresas. Mientras que el entrenamiento de modelos es finito y predecible, la inferencia genera datos continuamente que requieren almacenamiento, copia de seguridad y gestión a largo plazo.
El costo oculto del almacenamiento en IA
Según datos de Western Digital y un estudio patrocinado por la consultora IDC con 763 tomadores de decisiones, casi el 95% de las organizaciones reportó un aumento en volumen de datos por IA generativa en los últimos 12 meses, con el 61% registrando crecimientos de 25% o más. El almacenamiento en infraestructura de IA no es solo capacidad: es un componente crítico que debe mantenerse activo para evitar que las GPU permanezcan inactivas esperando datos, lo que genera costos exponenciales. Un ejecutivo de proveedor de servicios en la nube señaló que tener más almacenamiento es una optimización para mantener las GPU ocupadas.
Volumen de datos y proyecciones de mercado
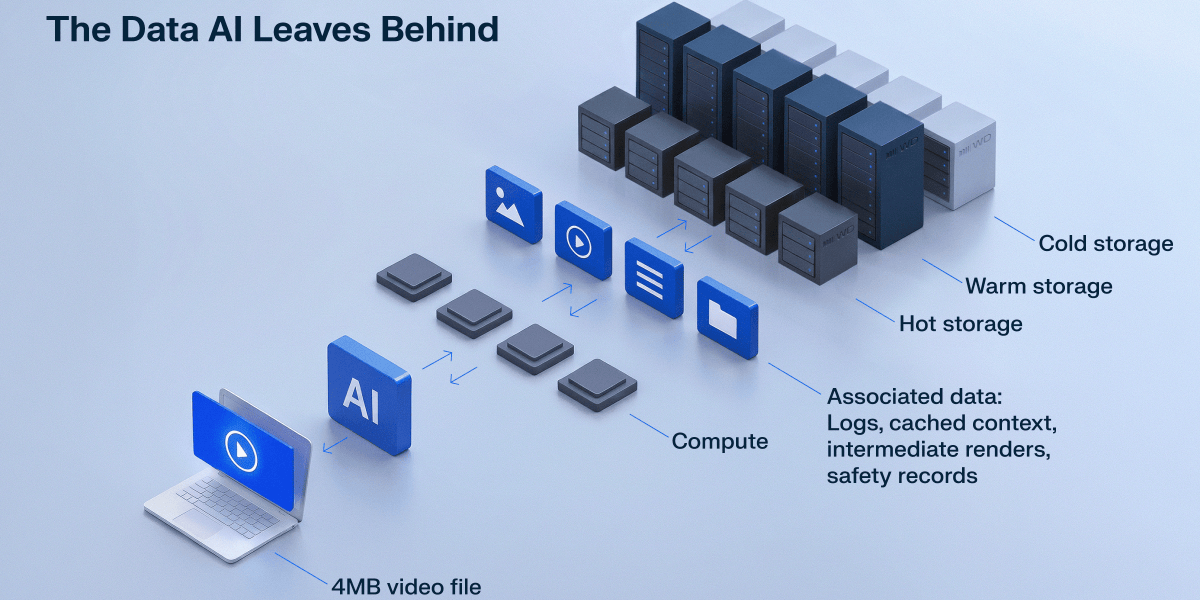
Un clip de video generado por IA de 8 segundos (3,97 MB a 720p) dejó más de 500 MB de datos asociados en el backend, incluyendo logs, contexto cacheado, renderizaciones inmediatas, copias de seguridad y registros de seguridad: un aumento de 130 veces sobre el archivo entregado al usuario. La demanda de inferencia en IA se proyecta en crecimiento de 35% anual hasta 2030, versus 22% para entrenamiento, alcanzando más del 40% de la demanda total de centros de datos para fin de década según McKinsey. El 96% de los encuestados anticipa necesidad de recuperación más rápida de archivo para soportar inferencia o generación aumentada por recuperación (RAG).
Impacto en presupuestos y ciclo de vida de datos
Para directivos financieros y de TI, esto significa que el gasto en infraestructura de IA puede estar dimensionado demasiado estrechamente en computación. Si el almacenamiento crece 25% anual mientras el presupuesto de computación sigue ciclos predecibles, el costo de almacenamiento eventualmente supera líneas presupuestarias mejor monitoreadas. Datos de modelo, logs, salidas sintéticas y resultados de inferencia se acumulan sin reducir volumen cuando la demanda de cómputo disminuye. Estos datos ahora se reutilizan como entrada para futuros procesos de IA, requiriendo acceso dinámico y tiering de almacenamiento (caliente, templado, frío) que equilibre rendimiento y costo.
| Dato | Detalle |
|---|---|
| Encuesta IDC | 763 tomadores de decisiones en TI y negocio |
| Aumento volumen IA (12 meses) | 95% de organizaciones reportó incremento |
| Crecimiento 25%+ anual | 61% de respondentes |
| Video 8 segundos (ejemplo) | 3,97 MB usuario vs. 500+ MB backend (130x) |
| Crecimiento inferencia (proyección) | 35% CAGR hasta 2030 vs. 22% entrenamiento |
| Demanda data center (2030) | Inferencia: más del 40% del total |
| Recuperación rápida archivo (RAG) | 96% anticipa necesidad |
| Datos asociados acumulan | Logs, contexto, renderizaciones, backups, registros de seguridad |
Preguntas frecuentes sobre almacenamiento de IA
¿Cuánto cuesta almacenar datos de IA en comparación con computación?
La fuente no proporciona cifras directas de comparación de costos. Sin embargo, advierte que el almacenamiento puede crecer 25% anual mientras la computación sigue ciclos predecibles, haciendo que en 12-18 meses el almacenamiento pase de ser "un redondeo" a una fracción significativa del presupuesto total.
¿Por qué la inferencia genera más datos que el entrenamiento?
El entrenamiento es un proceso finito: inicia, consume recursos y termina. La inferencia es continua: cada consulta a un modelo deja datos que deben almacenarse (logs, contexto, renders, copias de seguridad, registros). Estos nunca desaparecen automáticamente y se reutilizan en futuros procesos de IA.
¿Cómo deben estructurar las empresas su presupuesto de almacenamiento para IA?
La fuente sugiere alinear políticas de retención con el ciclo de vida real de los datos, no solo con costos iniciales. Requiere tiering de almacenamiento (caliente, templado, frío), tratar archivos como activos reutilizables para RAG e inferencia, y diseñar arquitectura para capacidad económicamente escalable.
El punto clave para la comunidad tech
Las organizaciones que planifican infraestructura de IA deben reconocer que el almacenamiento no es una línea presupuestaria menor ni predecible. A medida que la inferencia crece exponencialmente, los datos se acumulan indefinidamente, redefiniendo cómo calcular el costo total de propiedad de los sistemas de IA.
En Inteligencia Artificial creemos que esta es una lección crítica para CFOs y arquitectos de TI: ignorar almacenamiento hoy puede traducirse en sobrecostos severos cuando la demanda de IA doble o triplique. ¿Tu empresa ya monitorea el crecimiento de datos generados por IA de forma independiente?
Fuente: www.technologyreview.com
Deja una respuesta
Lo siento, debes estar conectado para publicar un comentario.