Crusoe y Perplexity: infraestructura IA a escala
⏱ Tiempo de lectura: 4 min
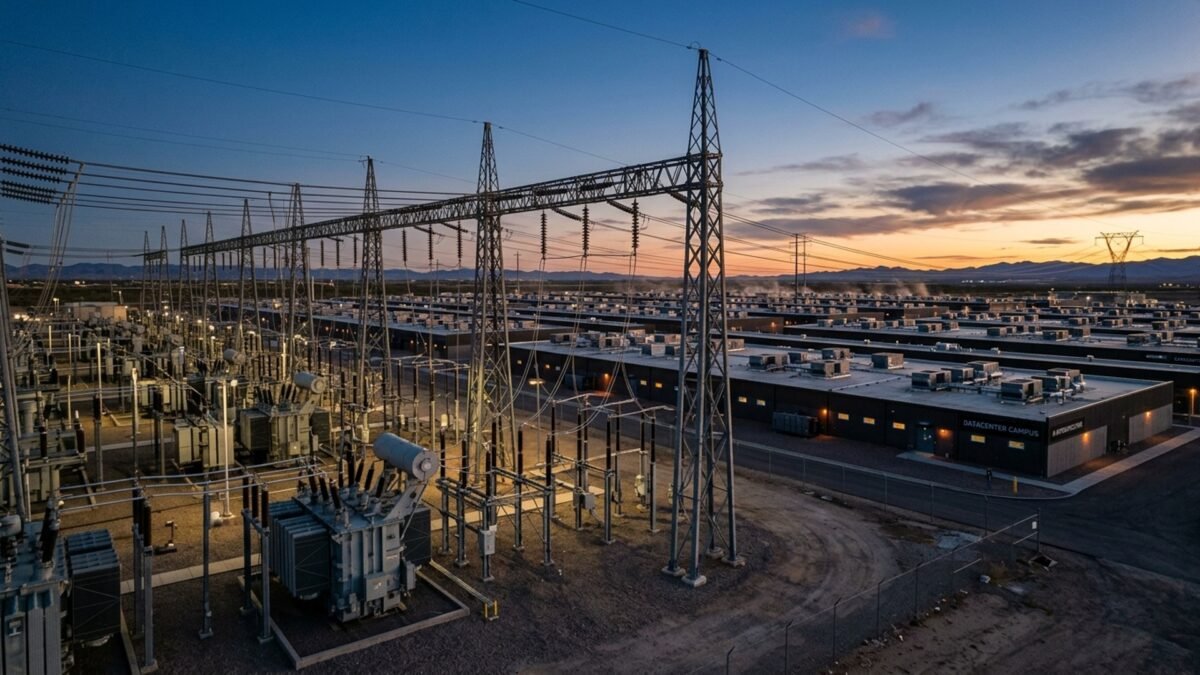
Crusoe Energy anunció el 15 de septiembre de 2026 una asociación plurianual con Perplexity para ejecutar el ciclo completo de modelos en Crusoe Cloud. Perplexity entrenará modelos frontera en clusters dedicados con GPUs NVIDIA GB300 NVL72 y los servirá en producción mediante el servicio Managed Inference de Crusoe. Ambas empresas buscan optimizar latencia y rendimiento para operaciones en tiempo real a millones de usuarios simultáneos.
Acuerdo de infraestructura IA entre Crusoe y Perplexity
El comunicado, fechado en San Francisco, incluye además que Crusoe adoptará Perplexity Enterprise Pro y Max para sus 1.800 empleados, proporcionando búsqueda de conocimiento web e interno, investigación multietapa, análisis de datos y acceso a modelos de IA frontera. Chase Lochmiller, cofundador y CEO de Crusoe, afirmó que las empresas de IA más ágiles necesitan infraestructura que escale con ellas en todo el ciclo de vida del modelo. Aravind Srinivas, cofundador y CEO de Perplexity, destacó que cada milisegundo de latencia es percibido por los usuarios en su plataforma, razón por la cual Crusoe fue seleccionada por su enfoque en inferencia de alto rendimiento y baja latencia con hardware de próxima generación. Perplexity continúa expandiendo su infraestructura crítica.
Especificaciones técnicas y rendimiento del hardware
Los clusters de entrenamiento dedicados utilizan NVIDIA GB300 NVL72, un sistema de escala de rack completamente refrigerado por líquido que integra 72 GPUs Blackwell Ultra y 36 CPUs Arm-based Grace. Las especificaciones incluyen 130 TB/s de ancho de banda NVLink, 20 TB de memoria GPU con hasta 576 TB/s de ancho de banda, 37 TB de memoria rápida y 2.592 núcleos CPU Arm Neoverse V2. Cada GPU recibe conectividad de red de 800 Gb/s mediante un módulo SuperNIC ConnectX-8, compatible con redes Quantum-X800 InfiniBand o Spectrum-X Ethernet. NVIDIA asegura que las fábricas de IA basadas en GB300 NVL72 entregan hasta 50x de aumento en rendimiento general comparado con plataformas basadas en Hopper, atribuido a mejora de 10x en respuesta del usuario (tokens por segundo por usuario) y 5x en rendimiento por megavatio, con la salvedad de que estas son métricas proyectadas sujetas a cambio. El servicio Managed Inference, disponible generalmente desde noviembre de 2025, utiliza el motor de inferencia propietario MemoryAlloy, que elimina prefills duplicados permitiendo a GPUs obtener cachés de prefijo desde nodos locales y remotos, logrando 9,9x más rápido tiempo a primer token y 5x mayor rendimiento comparado con vLLM en modelo Llama-3.3-70B en despliegue de cuatro nodos. Fuente: www.unite.ai
Opciones de despliegue y modelos disponibles
Crusoe ofrece Managed Inference en tres modalidades: Serverless Inference para consumo basado en uso de modelos abiertos mediante API completamente gestionada, orientada a cargas iniciales, tráfico bajo y experimentación rápida; Self-Serve Deployments, ahora generalmente disponibles, optimizados para rendimiento o capacidad de respuesta, incluyendo modelos personalizados con fine-tuning serverless; y Tailored Deployments que vinculan clientes con el equipo de Crusoe para endpoints dedicados y benchmarked, orientados a modelos propietarios. Los desarrolladores acceden mediante Crusoe Intelligence Foundry, hub donde generan claves API, usan endpoints gestionados ajustados por modelo, monitorean métricas de rendimiento y habilitan rendimiento provisionado para despliegues a escala de producción. El hub de modelos lista modelos abiertos preconfigurados de DeepSeek, Google, Z.ai, OpenAI, Meta, Alibaba y NVIDIA con conteos de parámetros y longitudes de contexto especificadas para cada uno.
Por qué este dato es relevante
Este acuerdo representa un paso significativo en la consolidación de infraestructura especializada para IA en producción. Mientras Perplexity escala su servicio de búsqueda impulsado por IA, contar con infraestructura optimizada para latencia baja es crítico para mantener experiencia de usuario fluida. Para el ecosistema hispanohablante de desarrolladores e empresas IA, el anuncio ilustra cómo las startups frontera están integrando hardware, software y servicios gestionados de forma vertical para competir en mercados globales de inferencia.
| Componente | Detalle |
|---|---|
| Fecha del acuerdo | 15 de septiembre de 2026 |
| GPU de entrenamiento | NVIDIA GB300 NVL72 (72 Blackwell Ultra GPUs + 36 Arm Grace CPUs) |
| Ancho de banda NVLink | 130 TB/s |
| Memoria GPU | 20 TB con hasta 576 TB/s de ancho de banda |
| Conectividad por GPU | 800 Gb/s mediante ConnectX-8 SuperNIC |
| Mejora GB300 vs Hopper | Hasta 50x rendimiento general (10x respuesta usuario, 5x por megavatio) |
| Managed Inference disponible | Desde noviembre de 2025 |
| Mejora MemoryAlloy vs vLLM | 9,9x tiempo a primer token, 5x rendimiento (Llama-3.3-70B) |
| Modelos en hub | DeepSeek, Google, Z.ai, OpenAI, Meta, Alibaba, NVIDIA |
| Adopción interna Crusoe | Perplexity Enterprise Pro y Max para 1.800 empleados |
Preguntas frecuentes sobre el acuerdo Crusoe-Perplexity
¿Qué exactamente es MemoryAlloy?
MemoryAlloy es el motor de inferencia propietario de Crusoe que elimina cachés de prefijo duplicados permitiendo que GPUs obtengan datos desde nodos locales y remotos, optimizando latencia y rendimiento en despliegues distribuidos.
¿Cuándo estará disponible este acuerdo?
Crusoe Managed Inference está generalmente disponible desde noviembre de 2025. Las opciones Self-Serve están disponibles ahora. Tailored Deployments requieren coordinación directa con el equipo de Crusoe.
¿Puedo usar estos servicios sin ser Perplexity?
Sí. Crusoe ofrece acceso público a Managed Inference a través de Crusoe Intelligence Foundry con modelos abiertos de múltiples proveedores, independientemente del acuerdo con Perplexity.
Qué falta por confirmar
La fuente no especifica plazos exactos para todas las optimizaciones de rendimiento ni detalles sobre costos específicos del servicio. Las métricas de rendimiento de GB300 NVL72 son proyectadas y sujetas a cambio según NVIDIA. Tampoco hay precisión sobre ventanas de expansión de modelos en el hub de Crusoe o términos comerciales completos del acuerdo plurianual.
En Inteligencia Artificial, este acuerdo refleja una estrategia clara: la infraestructura especializada para IA es ahora factor competitivo crítico. Las empresas que cierren brechas entre hardware, software y operaciones ganarán ventaja en mercados donde cada milisegundo cuenta. ¿Veremos más integraciones verticales de este tipo en 2027?
Deja una respuesta
Lo siento, debes estar conectado para publicar un comentario.