Embeddings: cómo la IA representa significado
⏱ Tiempo de lectura: 4 min
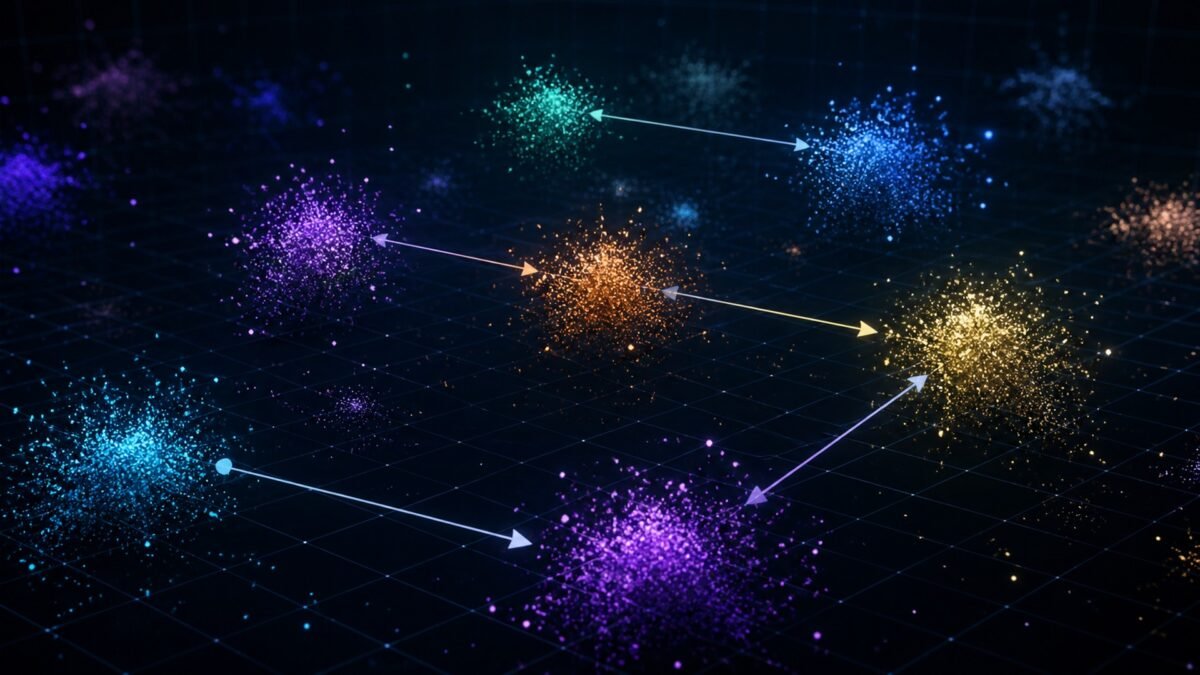
Los embeddings son vectores numéricos densos que permiten a los sistemas de inteligencia artificial representar el significado mediante números. Estos vectores se entrenan para que elementos con relaciones semánticas o conductuales útiles ocupen regiones cercanas en un espacio de representación. Comprender embeddings requiere precisión, ya que el término identifica un flujo de información, una decisión de entrenamiento, un mecanismo en tiempo de ejecución o un límite de gobernanza específicos. Confundirlo con «IA avanzada» hace imposible verificar las afirmaciones.
Qué son los embeddings en inteligencia artificial
Un embedding es un vector numérico denso aprendido durante el entrenamiento de un modelo. Su propósito es que elementos con relaciones semánticas o conductuales útiles se ubiquen cerca entre sí en el espacio de representación. La definición implica tres compromisos prácticos: una entrada identificable, una transformación característica de los embeddings y un resultado evaluable contra un objetivo declarado. Sin estos tres elementos, el término describe una aspiración más que un mecanismo implementado. Los embeddings diferencian el comportamiento aprendido del modelo de la decisión de producto sobre cuándo, dónde y con qué autoridad ese comportamiento se usa. En investigación de IA, separar ambos niveles es fundamental para entender qué falló y cómo controlarlo.
Cinco fases operativas de los embeddings
Un sistema típico de embeddings recorre cinco etapas. No todos los sistemas implementan cinco componentes distintos—algunos combinan fases, otros las repiten en bucle—pero este modelo fuerza que cada cambio de información o autoridad tenga un propietario, entrada, salida y prueba verificable. La primera fase codifica un elemento con un modelo entrenado; la segunda produce un vector de longitud fija; la tercera normaliza o indexa la representación; la cuarta compara vectores usando una función de similitud; la quinta usa los vecinos más cercanos para recuperación, agrupación o características adicionales. En cada transición, los equipos deben registrar incertidumbres, alternativas rechazadas, recursos utilizados y controles aplicados. Ese rastro revela si la cercanía vectorial refleja el objetivo de entrenamiento y preserva correlaciones no deseadas antes de que debilidades lleguen a una salida crítica. Fuente completa: www.unite.ai
Entrada, transformación y verificación
La calidad de un embedding depende de cómo se entrena el modelo inicial y de las decisiones que rodean cada etapa. Un revisor debe poder distinguir la operación de un campo de base de datos legible que contenga el significado del elemento y reproducir el resultado bajo las mismas condiciones declaradas. El flujo desde la codificación hasta la producción del vector fijo define si la cercanía de vectores refleja la intención del entrenamiento. La normalización o indexación afecta cómo se comparan vectores después. La función de similitud elige qué relaciones se consideran relevantes. Finalmente, el uso de vecinos cercanos para recuperación, agrupación o features determina el impacto práctico. Sin trazabilidad en cada límite, los equipos cierren debilidades críticas o sesgo no intencional antes de que alcancen decisiones importantes.
| Fase | Función | Entrada y salida |
|---|---|---|
| 1. Codificación | Transforma elemento con modelo entrenado | Entrada: elemento, salida: vector bruto |
| 2. Vector fijo | Produce representación de longitud fija | Entrada: vector bruto, salida: vector normalizado |
| 3. Normalización | Normaliza o indexa la representación | Entrada: vector, salida: índice o escala |
| 4. Similitud | Compara vectores con función de similitud | Entrada: dos vectores, salida: puntuación |
| 5. Vecinos | Usa vecinos cercanos para recuperación | Entrada: vector consultado, salida: conjunto recomendado |
Preguntas frecuentes sobre embeddings
¿Qué diferencia un embedding de un campo de base de datos legible?
Un embedding es un vector numérico aprendido mediante entrenamiento; un campo de base de datos es texto o metadatos almacenados. Los embeddings permiten buscar por similitud semántica; los campos legibles solo coinciden si son idénticos. La causa de éxito es distinta, los recursos dominantes difieren y los controles para evitar daño varían.
¿Por qué es importante mapear las cinco fases?
Porque cada etapa introduce decisiones que afectan el resultado final. Leer el mapa hacia adelante muestra cómo una fase alimenta la siguiente; leerlo hacia atrás desde un resultado incorrecto, lento, costoso o inseguro revela dónde falló la suposición inicial, frecuentemente antes de que el modelo produjera algo.
¿Cómo se verifica que un embedding funciona correctamente?
Comparando si la cercanía de vectores refleja el objetivo de entrenamiento declarado. Registrar incertidumbres, alternativas rechazadas y controles en cada transición permite detectar si correlaciones no deseadas persisten antes de impactar decisiones importantes.
Qué conviene mirar de cerca
La fuente subraya que embeddings es un término técnico preciso, no sinónimo de «IA avanzada». Confundirlo con conceptos vagos imposibilita verificar afirmaciones. Separar el comportamiento del modelo del proceso de decisión del producto es fundamental para governance, auditoría y confianza en sistemas que dependen de embeddings para recuperación, segmentación o generación de features críticas.
En Inteligencia Artificial, la precisión en definiciones técnicas es base para construir sistemas confiables y auditables. ¿Cuán a menudo en tus proyectos verificas que cada etapa de un pipeline de embeddings tiene dueño, entrada, salida y prueba clara?
Fuente: www.unite.ai
Deja una respuesta
Lo siento, debes estar conectado para publicar un comentario.